

Statistik kritisch hinterfragen
Weiterführend:
- Vorwissen: Daten visualisieren (Diagramme)
- Vorwissen: Statistische Kennwerte (Lage- und Streumasse)
- Vorwissen: Grundlagen & Datenerhebung
Lehrplan 21
MA.3.B.1.iGrundanspruchErgebnisse zu funktionalen Zusammenhängen überprüfen, insbesondere durch Interpretation von Tabellen, Graphen und DiagrammenMA.3.B.2.eGrundanspruchHäufigkeiten experimentell bestimmen und Vermutungen zu Wahrscheinlichkeiten formulieren; unbekannte Fragestellungen zu Kombinatorik/Wahrscheinlichkeit bearbeitenMA.3.C.2.gGrundanspruchAbhängigkeit zweier Grössen mit Funktionsgraph darstellen; Graphenverläufe interpretieren (Erw: geeignete Skalierung wählen; lineare funktionale Zusammenhänge mit Term beschreiben)MA.3.B.1.jFunktionale und statistische Zusammenhänge erforschen; statistische Rohdaten zu sozialen/wirtschaftlichen/ökologischen Fragestellungen erforschenMA.3.B.2.fWahrscheinlichkeiten und statistische Angaben überprüfen und begründenMA.3.C.2.hWertetabellen, Diagramme, Sachtexte, Terme und Graphen einander zuordnen und interpretieren; Sachsituationen nach funktionalen, statistischen und probabilistischen Gesichtspunkten bearbeiten
Quelle: Aargauer Lehrplan Volksschule, Fachbereich Mathematik (August 2022)
Kritisch hinterfragen: die Idee
Abschnitt betitelt „Kritisch hinterfragen: die Idee“Statistik kritisch zu hinterfragen bedeutet, Zahlen nicht blind zu glauben. Du prüfst sie systematisch. Du schaust hinter die Kulissen der Darstellung. Das heisst nicht, alle Statistiken abzulehnen. Es bedeutet, ihre Qualität zu beurteilen.
Drei zentrale Bereiche helfen dir beim kritischen Lesen. Erstens die Datenerhebung: Wer hat die Daten gesammelt? Wie gross war die Stichprobe? War sie repräsentativ? Zweitens die Darstellung: Ist die Grafik fair skaliert? Verzerren Farben oder 3D-Effekte? Drittens die Interpretation: Stimmt die angegebene Schlussfolgerung überhaupt? Wird Korrelation mit Kausalität verwechselt?
Ein einfaches Beispiel verdeutlicht den Unterschied. Ein Säulendiagramm zeigt zwei Werte: und . Startet die y-Achse bei , siehst du einen kleinen Unterschied. Startet sie bei , ragt die erste Säule nur Einheiten über die Achse, die zweite Einheiten. Die zweite Säule ist dann -mal so hoch wie die erste. Die Zahlen sind identisch, die Wirkung ist völlig verschieden.
Das Ziel dieser Lektion ist klar. Du sollst nicht paranoid werden. Du sollst ein geübtes Auge entwickeln. Jede Statistik verdient eine kurze Prüfung: Stimmt die Quelle? Passt die Darstellung zum Inhalt? Ist die Schlussfolgerung logisch? Mit wenigen Sekunden Aufmerksamkeit filterst du die meisten Fehlinformationen heraus.
Kritisch hinterfragen: der Rechenweg
Abschnitt betitelt „Kritisch hinterfragen: der Rechenweg“Für das systematische Hinterfragen von Statistiken gibt es eine bewährte Methode. Sie basiert auf fünf W-Fragen. Diese Fragen kannst du bei jeder Grafik und bei jeder Zahl stellen.
Jede Frage hat ihren Zweck. Die Wer-Frage entlarvt versteckte Interessen. Eine Studie der Tabakindustrie zum Rauchen ist mit Vorsicht zu geniessen. Die Was-Frage klärt Definitionen. Sogar in der Schweiz gibt es zwei Zahlen zur Arbeitslosigkeit: Die Arbeitslosenquote des SECO zählt nur Personen, die beim RAV gemeldet sind. Die Erwerbslosenquote des BFS beruht auf einer Befragung nach internationaler Definition und fällt höher aus.
Die Wann-Frage enthüllt Cherry-Picking. Wer nur den besten oder schlechtesten Zeitraum zeigt, verzerrt das Bild. Die Wie-Frage untersucht die technische Qualität. Achsenskalierung, Stichprobengrösse und Erhebungsmethode gehören hierher.
Die Warum-Frage schliesslich beleuchtet die Absicht. Marketing, Politik oder Wissenschaft haben unterschiedliche Motive. Eine Gewinnmeldung eines Unternehmens ist anders zu lesen als eine Studie eines unabhängigen Instituts.
Für die mathematische Analyse sind zwei Konzepte zentral. Die relative Abweichung eines Werts von einem Vergleichswert berechnest du mit:
So erkennst du, ob ein Unterschied wirklich bedeutend ist. Der zweite Begriff ist die Stichprobengrösse . Je grösser , desto kleiner die Fehlermarge einer Umfrage. Als Faustregel (bei Sicherheit) gilt:
Bei sind das , also rund Prozentpunkte. Eine solche Umfrage ist wenig aussagekräftig. Bei sind es nur noch , also etwa Prozentpunkte. Darum arbeiten gute Umfragen mit .
Die abgeschnittene Achse
Abschnitt betitelt „Die abgeschnittene Achse“Ein Unternehmen präsentiert seinen Umsatz über drei Jahre:
| Jahr | Umsatz (Mio. CHF) |
|---|---|
| 2024 | |
| 2025 | |
| 2026 |
Aufgabe: Ein Säulendiagramm startet bei Mio. CHF. Wie wirkt die zweite Säule im Vergleich zur ersten? Und wie wirkt sie, wenn die Achse bei beginnt?
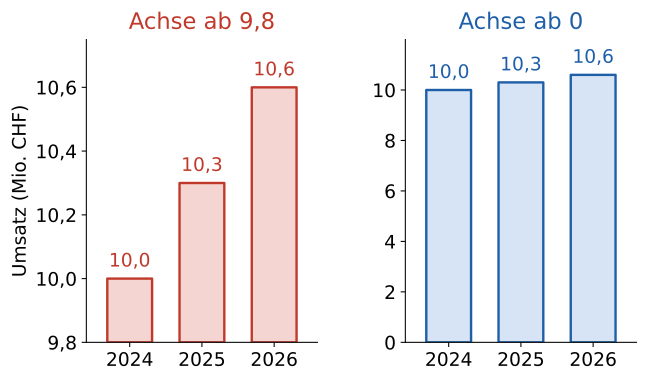
Abb. 1: Dieselben Zahlen, zwei Achsen. Links ist die Säule für 2025 -mal so hoch wie die für 2024, rechts sieht man den echten Zuwachs von .
Lösung:
Bei einer Achse ab Mio. ist der sichtbare Säulenabschnitt der ersten Säule Einheiten hoch. Die zweite Säule zeigt Einheiten. Der optische Unterschied:
Die zweite Säule wirkt also -mal so gross. Bei einer Achse ab ist das Verhältnis . Der tatsächliche Zuwachs beträgt nur . Die dritte Säule wirkt mit sogar viermal so hoch wie die erste, obwohl der Umsatz nur um gestiegen ist. Die abgeschnittene Achse täuscht einen massiven Anstieg vor.
Das verzerrte Kreisdiagramm
Abschnitt betitelt „Das verzerrte Kreisdiagramm“Ein 3D-Kreisdiagramm zeigt die Marktanteile dreier Firmen. Firma A hat , Firma B und Firma C . Firma A liegt im Vordergrund und wirkt deutlich grösser als Firma B.
Aufgabe: Erkläre den Trick. Wie kannst du den tatsächlichen Anteil prüfen?
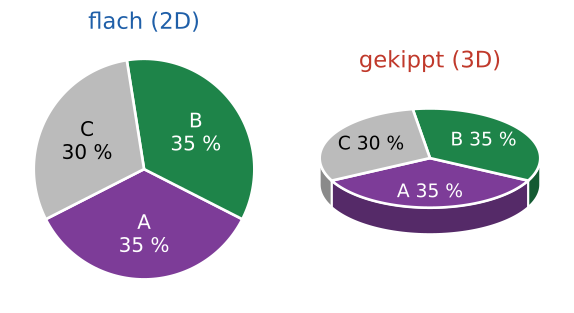
Abb. 2: Dieselben Anteile, flach und gekippt. Im 3D-Bild bedeckt Firma A knapp die Hälfte der eingefärbten Fläche, Firma B nur gut ein Viertel.
Lösung:
3D-Effekte verzerren Flächen. Der vordere Sektor wirkt aus zwei Gründen grösser. Erstens erscheint er durch das Kippen breiter: In Abb. 2 öffnet sich A scheinbar auf rund statt auf . Zweitens sieht man nur bei den vorderen Sektoren zusätzlich den Rand des «Kuchens». Dabei hat A denselben Winkel wie B. Der Winkel entspricht dem Prozentsatz:
Firma A und Firma B haben identische Winkel von , Firma C hat . Nur die Perspektive täuscht. Du prüfst die Aufteilung, indem du die angegebenen Prozentwerte nachrechnest: und . Die Zahlen stimmen, doch das Bild lügt. Fordere eine flache, faire Darstellung. Ein einfaches Balkendiagramm wäre objektiver. Merke dir als Regel: Kreisdiagramme immer in 2D darstellen und Sektoren nicht herausziehen.
Ein verwandter Flächentrick steckt in Piktogrammen. Steigt der Umsatz einer Firma von auf Mio. CHF, zeichnet eine Grafik den Geldschein für Mio. oft doppelt so hoch und doppelt so breit. Seine Fläche ist dann -mal so gross. Das Auge vergleicht Flächen, nicht Höhen. Der Zuwachs wirkt also vierfach statt doppelt. Allgemein gilt: Wird ein Bild in Breite und Höhe mit dem Faktor vergrössert, wächst seine Fläche mit dem Faktor .
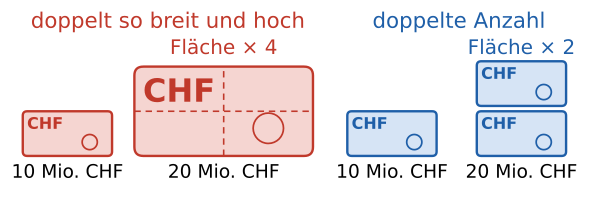
Abb. 3: Links passt der kleine Schein viermal in den grossen, obwohl sich der Umsatz nur verdoppelt hat. Ehrlich ist es, gleich grosse Symbole zu wiederholen.
Typische Fehler bei Kritisch hinterfragen
Abschnitt betitelt „Typische Fehler bei Kritisch hinterfragen“Beim Analysieren von Statistiken lauern viele Fallen. Die folgenden Warnungen helfen dir, die häufigsten Fehler zu vermeiden.
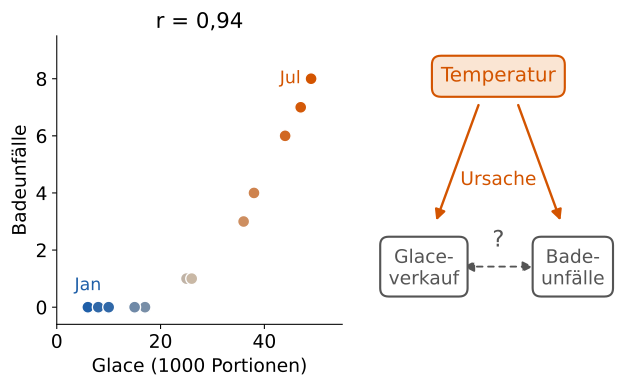
Abb. 4: Modelldaten für ein Jahr. Glaceverkauf und Badeunfälle korrelieren stark (). Die Ursache für beides ist die Temperatur: Die kalten Monate liegen unten links, die warmen oben rechts.
Kritisch hinterfragen in Aufgaben
Abschnitt betitelt „Kritisch hinterfragen in Aufgaben“Cherry-Picking beim Zeitraum
Abschnitt betitelt „Cherry-Picking beim Zeitraum“Eine Zeitung titelt: «Temperatur weltweit stagniert seit 1998!» Sie zeigt einen Graphen der Jahresdurchschnittstemperaturen von bis . Die Kurve ist nahezu flach.
Aufgabe: Analysiere den Trick. Warum ist diese Darstellung irreführend?
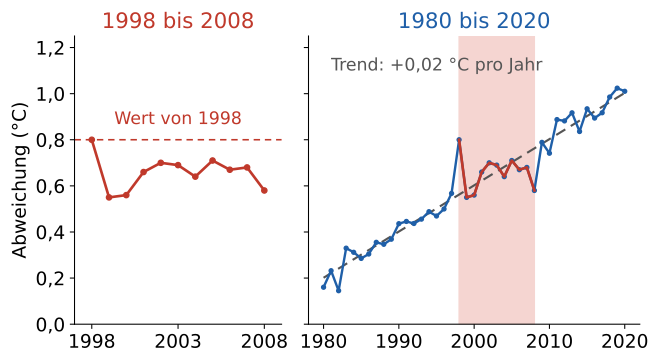
Abb. 5: Modelldaten mit einem Trend von pro Jahr und zufälligen Schwankungen. Der rote Ausschnitt startet beim Ausreisser 1998 und wirkt darum flach.
Lösung:
Das Jahr war ein extremes El-Niño-Jahr mit ungewöhnlich hohen Temperaturen. Durch die Wahl dieses Startpunkts wirkt jedes Folgejahr kühler. Der wahre langfristige Trend wird verdeckt.
Nimmst du stattdessen den Zeitraum von bis , zeigt sich ein klarer Anstieg von etwa:
Auf Jahre verteilt entspricht das einer durchschnittlichen Erwärmung von pro Jahr. Die kurze, ausgewählte Zeitspanne verbirgt diesen Trend. Dieses Vorgehen heisst Cherry-Picking. Der Name kommt vom Kirschenpflücken: Man pflückt nur die Früchte, die einem passen, und lässt den Rest hängen.
Achte bei Trendaussagen immer auf die Zeitspanne. Kurze Ausschnitte sind fast immer verdächtig. Je länger der Zeitraum, desto zuverlässiger die Aussage. In der Klimaforschung gelten mindestens Jahre als aussagekräftige Basis.
Korrelation und Kausalität
Abschnitt betitelt „Korrelation und Kausalität“Eine Studie behauptet: «Menschen, die regelmässig Kaffee trinken, sind glücklicher.» Die Korrelation beträgt .
Aufgabe: Was könnte diese Aussage wirklich bedeuten? Diskutiere alternative Erklärungen.
Lösung:
Die Korrelation von ist moderat positiv. Doch Korrelation beweist keine Kausalität. Mehrere Erklärungen sind möglich:
- Kaffee macht glücklich (Koffein als Stimmungsheber).
- Glückliche Menschen trinken mehr Kaffee (soziale Treffen im Café).
- Eine dritte Variable steckt dahinter: Berufstätige trinken häufiger Kaffee und sind dank Arbeit und Einkommen im Schnitt zufriedener.
Die Korrelationsformel zeigt nur, dass beide Werte gemeinsam variieren:
Für Kausalität brauchst du Experimente: Eine Gruppe trinkt Kaffee, eine Kontrollgruppe nicht, und die Teilnehmenden werden den Gruppen zufällig zugeteilt. Erst dann kannst du Ursachen identifizieren. Beobachtungsstudien zeigen Zusammenhänge, keine Ursachen. Merke dir: «Correlation does not imply causation» – Korrelation bedeutet keine Kausalität.
Kritisch hinterfragen genauer betrachtet
Abschnitt betitelt „Kritisch hinterfragen genauer betrachtet“Fortgeschrittene Themen der kritischen Statistik betreffen Paradoxien und Verzerrungen. Zwei besonders wichtige Konzepte sind das Simpson-Paradoxon und die Grundraten-Vernachlässigung. Beide tauchen in Medizin, Politik und Wirtschaft regelmässig auf.
Das berühmteste Beispiel stammt von der Universität Berkeley aus dem Jahr . Die Universität fürchtete den Vorwurf, Frauen bei der Zulassung zu benachteiligen. Die Gesamtdaten zeigten: der Männer und nur der Frauen wurden zugelassen. Bei der Aufschlüsselung nach Fachrichtungen kehrte sich das Bild teilweise um. In einigen Fächern hatten Frauen sogar höhere Zulassungsquoten.
Die Erklärung: Frauen bewarben sich häufiger für sehr selektive Fächer. Männer wählten öfter weniger selektive Bereiche. Die versteckte Variable war die Fachwahl, nicht das Geschlecht. Ohne diese Aufschlüsselung wäre der falsche Schluss gezogen worden.
Ein Beispiel: Ein Test auf eine seltene Krankheit ist zu genau. Er erkennt der Kranken, und bei der Gesunden zeigt er korrekt «negativ» an. Die Krankheit betrifft von Menschen. Fällt dein Test positiv aus, bist du trotzdem nur mit einer Wahrscheinlichkeit von etwa krank.
Am einfachsten siehst du das mit ganzen Zahlen. Von Getesteten sind krank und gesund. Von den Kranken testet der Test positiv. Von den Gesunden erhalten , also Personen, fälschlich ein positives Ergebnis. Insgesamt gibt es positive Tests, und nur davon gehören zu Kranken:
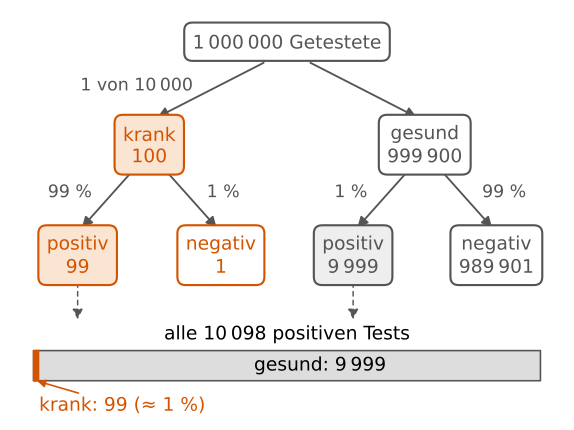
Abb. 6: Weil es so viel mehr Gesunde als Kranke gibt, sind fast alle positiven Tests Fehlalarme. Die Kranken machen nur rund der positiven Tests aus.
Dasselbe Ergebnis liefert der Satz von Bayes:
Diese Paradoxien zeigen, wie wichtig präzises Hinsehen ist. Durchschnittswerte und Gesamtstatistiken können trügen. Die Aufschlüsselung nach Untergruppen und der Blick auf die Grundrate zeigen oft erst das wahre Bild.
Das Simpson-Paradoxon
Abschnitt betitelt „Das Simpson-Paradoxon“Zwei Therapien gegen Nierensteine werden verglichen. Die Zahlen stammen aus einer bekannten Studie. Insgesamt hat Therapie A eine Erfolgsquote von und Therapie B von . Aufgeschlüsselt nach Schweregrad zeigt sich:
| Schweregrad | Therapie A | Therapie B |
|---|---|---|
| leicht (kleine Steine) | () | () |
| schwer (grosse Steine) | () | () |
Aufgabe: Welche Therapie ist besser? Warum widerspricht die Gesamtstatistik den Einzeldaten?
Lösung:
Therapie A ist in jeder Untergruppe besser! Bei leichten Fällen: gegen . Bei schweren Fällen: gegen . Dennoch wirkt Therapie B insgesamt besser.
Die Berechnung der Gesamtquoten:
Die Erklärung liegt in der unterschiedlichen Verteilung. Therapie A wurde meist bei schweren Fällen angewendet ( von Patienten), wo die Quoten generell niedriger sind. Therapie B dagegen wurde hauptsächlich bei leichten Fällen eingesetzt ( von ). Diese Gewichtung zieht den Gesamtwert von A nach unten.
Die Lehre: Vertraue nie blind der Gesamtstatistik. Frage nach Untergruppenanalysen. Sie zeigen die wahre Struktur der Daten. In der Medizin ist diese Aufschlüsselung Standard bei klinischen Studien.
Übungen
Abschnitt betitelt „Übungen“Bearbeite diese Aufgaben selbständig. Die Schwierigkeit steigt von Aufgabe bis Aufgabe .
Aufgabe 1: Ein Säulendiagramm zeigt Umsätze: , , . Die y-Achse beginnt bei . Berechne, wie viel grösser die dritte Säule optisch im Vergleich zur ersten wirkt.
Aufgabe 2: Eine Firma wirbt: «Unser Produkt reduziert das Risiko um !» Das Risiko sinkt von auf . Beurteile die absolute und die relative Veränderung.
Aufgabe 3: Eine Umfrage mit ergibt: der Befragten bevorzugen Produkt X. Die Schlagzeile lautet: « aller Konsumenten lieben Produkt X.» Kritisiere die Aussage.
Aufgabe 4: Ein 3D-Kreisdiagramm zeigt die Werte , und . Berechne die Winkel der drei Sektoren. Wie kannst du die Darstellung fair machen?
Aufgabe 5: Ein Graph zeigt den Aktienkurs von bis mit starkem Anstieg. Der -Jahres-Graph zeigt dagegen einen klaren Abwärtstrend. Erkläre, welches Bild verlässlicher ist und warum.
Aufgabe 6: Die Korrelation zwischen Schokoladenkonsum und Nobelpreisen pro Land beträgt . Nenne drei mögliche Erklärungen, die keinen direkten Kausalzusammenhang voraussetzen.
Aufgabe 7: Eine Zeitung schreibt: «Verkehrstote um gestiegen!» Die absoluten Zahlen: von auf . Eine zweite Zeitung meldet: «Nur Verkehrstote mehr.» Diskutiere beide Schlagzeilen.
Aufgabe 8: Ein Test erkennt aller Kranken. Die Krankheit betrifft von Menschen. Bei Gesunden zeigt der Test in der Fälle fälschlich «positiv» an (Falsch-Positiv-Rate). Es werden Million Menschen getestet. Berechne, wie viele Gesunde fälschlich positiv getestet werden und welcher Anteil der positiv Getesteten wirklich krank ist.
Aufgabe 9: Zwei Schulen haben je eine Fremdsprachen- und eine Naturwissenschaftsklasse. Schule A: Fremdsprache bestanden ( von ), Naturwissenschaft ( von ). Schule B: Fremdsprache ( von ), Naturwissenschaft ( von ). Berechne die Gesamtquoten und erkläre das Simpson-Paradoxon.
Aufgabe 10: Eine Studie behauptet: «Menschen, die Vitamin C einnehmen, werden seltener krank.» Die Studie wurde von einem Vitamin-Hersteller finanziert und umfasste Freiwillige. Wende die 5-W-Checkliste an und bewerte die Aussage.
Das Wichtigste in Kürze
Abschnitt betitelt „Das Wichtigste in Kürze“Statistiken kritisch zu hinterfragen ist eine Kernkompetenz der digitalen Welt. Die wichtigsten Prinzipien sind: Prüfe die Achsenskalierung und verlange bei Säulendiagrammen eine Achse ab . Achte auf Flächen: Doppelte Breite und doppelte Höhe ergeben die vierfache Fläche. Hinterfrage Stichprobengrösse und Auswahl der Befragten. Unterscheide absolute von relativen Zahlen. Verwechsle Korrelation nie mit Kausalität. Analysiere immer die Quelle und ihre Interessen. Wende die 5-W-Checkliste an: Wer, Was, Wann, Wie, Warum. Achte auf versteckte Variablen, Grundraten und mögliche Paradoxien. Eine gute Datenjournalistin nennt Quelle, Stichprobe und Methode. Fehlen diese Angaben, sei skeptisch. Mit wenigen Sekunden Prüfung erkennst du die meisten Manipulationen. Diese Data-Literacy-Kompetenz schützt dich vor Fehlinformationen und stärkt dein kritisches Denken im Alltag.
Ein Säulendiagramm zeigt die Werte und . Die y-Achse startet bei . Wie gross erscheint der optische Unterschied? a) etwa gleich hoch, da die Werte fast identisch sind b) die zweite Säule wirkt etwa -mal so hoch c) die zweite Säule wirkt doppelt so hoch
Lösung anzeigen
c) Die erste Säule zeigt Einheiten, die zweite Einheiten. Optisch wirkt sie doppelt so hoch, obwohl der echte Unterschied nur beträgt.
Welches ist KEIN Warnzeichen für eine manipulierte Statistik? a) klare Angabe der Stichprobengrösse b) y-Achse eines Säulendiagramms beginnt bei statt c) 3D-Effekt auf einem Kreisdiagramm
Lösung anzeigen
a) Eine klare Angabe der Stichprobengrösse ist ein Qualitätsmerkmal. Die Optionen b) und c) sind klassische Manipulationstricks.
Was bedeutet «Cherry-Picking» in der Statistik? a) Auswählen eines vorteilhaften Zeitraums oder Datenausschnitts b) das Sammeln von Daten mit einer Stichprobe c) die Berechnung des Durchschnitts
Lösung anzeigen
a) Cherry-Picking beschreibt die selektive Auswahl günstiger Daten, um eine gewünschte Aussage zu stützen. Der Rest wird ignoriert.
Eine Studie zeigt: zwischen Kaffeekonsum und Glück. Was folgt daraus zwingend? a) Kaffee macht glücklich b) Glück führt zu mehr Kaffeekonsum c) nichts zwingend, Korrelation zeigt keine Kausalität
Lösung anzeigen
c) Korrelation zeigt nur, dass zwei Grössen gemeinsam variieren. Sie belegt keine Ursache-Wirkung-Beziehung.
Welche der 5-W-Fragen zielt auf versteckte Interessen der Quelle? a) Wie b) Wer c) Wann
Lösung anzeigen
b) Die Wer-Frage untersucht, wer die Daten erhoben und veröffentlicht hat. Sie deckt auch Finanzierung und Interessenkonflikte auf.
Ausblick
Abschnitt betitelt „Ausblick“Mit dem kritischen Hinterfragen von Statistiken beherrschst du eine zentrale Data-Literacy-Kompetenz. Als Nächstes kannst du tiefer in die beurteilende Statistik eintauchen. Dort lernst du Hypothesentests, Konfidenzintervalle und p-Werte kennen. Diese Werkzeuge helfen dir, Studienergebnisse wissenschaftlich korrekt zu interpretieren. Auch die explorative Datenanalyse mit Boxplots und Streudiagrammen wird spannend. Du wirst künftig nicht nur Statistiken lesen, sondern eigene Daten kompetent analysieren. In Studium und Beruf ist diese Fähigkeit unverzichtbar geworden.
Lösungen
Abschnitt betitelt „Lösungen“Lösung 1: Die sichtbaren Säulenabschnitte sind , und Einheiten hoch. Die dritte Säule wirkt optisch -mal so gross wie die erste. Der echte Unterschied beträgt nur . Die abgeschnittene Achse erzeugt einen viel zu dramatischen Eindruck.
Lösung 2: Relativ sinkt das Risiko um . Absolut sinkt es nur um , also von auf (um Prozentpunkte). Statt von Personen ist noch von betroffen. Das klingt beeindruckend, ist aber im Alltag kaum spürbar. Die Werbung verschweigt die geringe absolute Veränderung. Beides anzugeben wäre fair.
Lösung 3: Mit ist die Aussage nicht repräsentativ. Nach der Faustregel beträgt die Fehlermarge , also grob Prozentpunkte bei Sicherheit. Der wahre Anteil könnte also irgendwo zwischen etwa und liegen. Seriöse Umfragen brauchen . Zudem muss die Stichprobe zufällig und repräsentativ gezogen werden. Die Schlagzeile verallgemeinert unzulässig auf «alle Konsumenten», und «bevorzugen» ist nicht dasselbe wie «lieben».
Lösung 4: Die Winkel sind , und . Die Summe ergibt korrekt . Die faire Darstellung ist ein flaches 2D-Kreisdiagramm. Noch besser: ein Balkendiagramm mit identischer Balkenbreite. So lassen sich die Anteile direkt vergleichen.
Lösung 5: Der -Jahres-Graph ist verlässlicher. Kurze Zeiträume zeigen vor allem Schwankungen (Rauschen). Langfristige Trends werden erst über längere Zeit sichtbar. Wer nur eine kurze Periode herauspickt, betreibt Cherry-Picking und verzerrt das Bild. In der Finanzanalyse gelten mindestens bis Jahre als aussagekräftige Basis für Trendaussagen.
Lösung 6: Mögliche Erklärungen ohne direkte Kausalität: 1) Beide hängen vom Wohlstand ab: Reichere Länder konsumieren mehr Schokolade und investieren mehr in Forschung. 2) Gut ausgebaute Bildungssysteme finden sich vor allem in Ländern, in denen Schokolade traditionell beliebt ist. 3) Zufall und kleine Zahlen: Nobelpreise sind selten, schon wenige Preise mehr oder weniger verändern die Werte eines Landes stark. Die wahrscheinlichste gemeinsame Ursache ist wirtschaftlicher Wohlstand.
Lösung 7: Zeitung 1 wählt die relative Darstellung: . Zeitung 2 wählt die absolute: Verkehrstote mehr. Beide Zahlen sind rechnerisch korrekt, aber die Wirkung ist verschieden. Bei kleinen Grundzahlen wirken relative Angaben schnell dramatisch und sind irreführend. Eine faire Darstellung nennt beides: relative und absolute Veränderung.
Lösung 8: Bei Getesteten sind Personen krank. Davon testet der Test positiv, also Personen. Gesund sind Personen. Davon werden fälschlich positiv getestet: Personen. Die Fehlalarme dominieren. Von den rund positiv Getesteten sind nur etwa tatsächlich krank.
Lösung 9: Schule A gesamt: . Schule B gesamt: . Schule B wirkt besser, obwohl Schule A in jeder Einzelklasse höhere Quoten hat ( und ). Das ist das Simpson-Paradoxon, verursacht durch die unterschiedliche Verteilung auf die Klassen. Schule A hat zwei Drittel ihrer Lernenden in der schwierigen Naturwissenschaftsklasse ( von ), Schule B dagegen die Mehrheit in der leichteren Fremdsprachenklasse ( von ).
Lösung 10: Wer: Vitamin-Hersteller, klarer Interessenkonflikt. Was: «Seltener krank» ist vage. Was genau wurde gemessen? Erkältungshäufigkeit, Krankheitstage, Schweregrad? Wann: Zeitraum der Studie unklar, etwa über welche Jahreszeit? Wie: ist viel zu klein. Keine Kontrollgruppe erwähnt, kein Doppelblindverfahren. Warum: Marketing für Vitaminprodukte. Fazit: Die Studie ist wissenschaftlich nicht belastbar. Du solltest unabhängige Übersichtsarbeiten konsultieren, zum Beispiel Cochrane-Reviews. Diese bewerten die Studienlage systematisch.
Quellen
- Lehrplan 21 — Mathematik — Deutschschweizer Erziehungsdirektoren-Konferenz (D-EDK)
- Lehrplan Volksschule Aargau — Mathematik — Kanton Aargau, Departement Bildung, Kultur und Sport